El 30 de octubre de 2026, cuatro de las mayores empresas de IA coincidieron en algo: una sola línea en el archivo robots.txt debería bastar para decir «no uses mis páginas para entrenar tus modelos». Para el propietario de un negocio es una pregunta antigua con forma nueva. ¿Hay que bloquear bots de IA por completo o dejar la web abierta para no desaparecer de las respuestas donde los clientes buscan proveedores? Los bots son fáciles de bloquear en lo técnico, pero la decisión sobre la IA es del negocio. Aquí van tres tipos de acceso, una matriz por tipo de página, un plan de 30 días y los límites del nuevo estándar.
Bloquear bots de IA: qué anunciaron las cuatro empresas y cuándo funcionará
Según la crónica de SiliconANGLE, Google, Microsoft, Anthropic y OpenAI apoyarán una entrada común en robots.txt que bloquea todos sus rastreadores de datos para entrenar modelos generativos. Un borrador del estándar se ha enviado al IETF. Hasta ahora había que listar a cada empresa y a cada uno de sus bots, por eso una regla de robots.txt gptbot nunca lo cubría todo.
Los plazos difieren. OpenAI y Microsoft hablan de los próximos meses, Google del año que viene y Anthropic no dio fecha en esa crónica. Meta respalda la idea, pero no se ha comprometido a implantarla. Por ahora es un borrador, no un interruptor para bloquear los bots de IA con un clic.
Entrenamiento, respuestas de IA y búsqueda: tres accesos distintos a tu web
Por qué una regla única para todos los bots falla
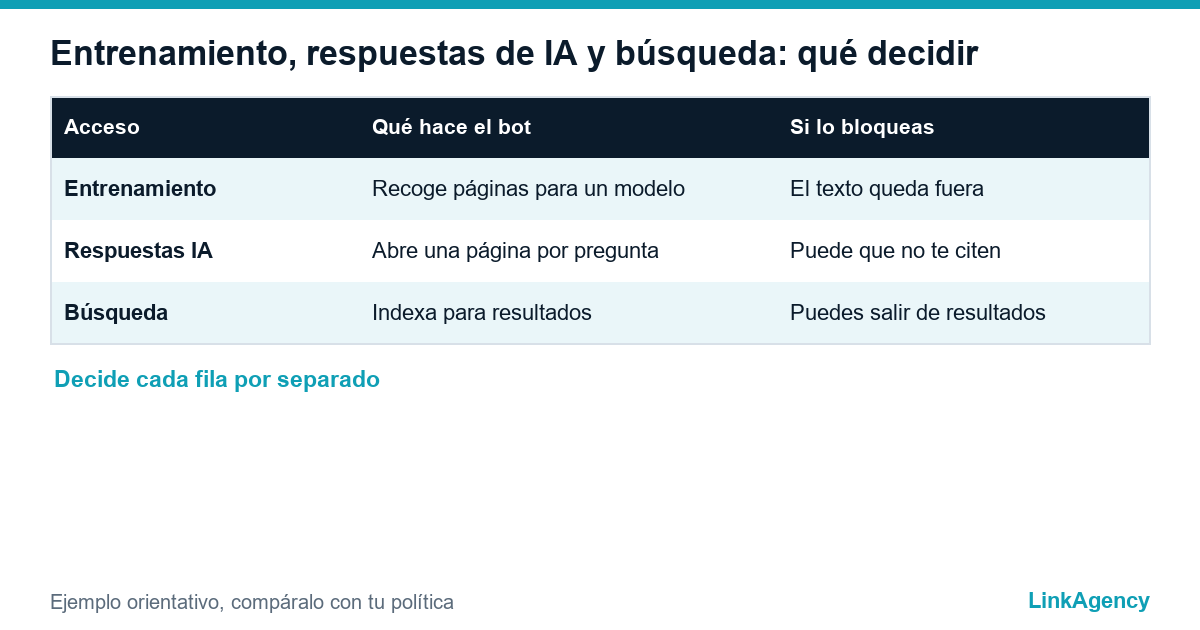
La confusión nace de tratar igual a todos los bots. En realidad los rastreadores de IA hacen tres trabajos, y cada uno tiene consecuencias distintas para el negocio.
| Tipo de acceso | Qué hace el bot | Si lo bloqueas |
|---|---|---|
| Entrenamiento | Recoge páginas para enseñar a un modelo | Tu texto queda fuera de futuras versiones |
| Respuestas de IA (grounding) | Abre una página para responder a una persona | Puede que no te nombren ni te enlacen |
| Búsqueda | Indexa páginas para los resultados normales | Puedes desaparecer de los resultados |
Microsoft afirma que añadirá un ajuste aparte, AI Grounding, para la segunda fila. La nueva entrada común solo toca la primera. Por eso, antes de bloquear rastreadores de IA, conviene decidir cada fila por separado y no con un único sí o no.
Qué pierdes si lo cierras todo y qué arriesgas si lo abres todo
Si decides bloquear los bots de IA sin matices, puedes salir de la búsqueda con IA y, con un rastreador mixto, también de la búsqueda normal. Cloudflare explica que un bot mixto indexa y entrena con una sola identidad, así que su ajuste «Block» ahora también afecta a la búsqueda, mientras que la opción «Disallow AI Training» te mantiene en los resultados. Abrirlo todo también cuesta, y por eso hay quien prefiere bloquear los bots de IA que solo toman: tu lógica de precios, tus guías de pago y tus estudios propios pueden acabar en modelos que nunca te enviarán una visita.
Matriz de decisiones: qué páginas cerrar al entrenamiento y cuáles dejar abiertas
- Páginas comerciales, servicios y casos de éxito: abiertas, porque traen consultas cuando las respuestas de IA te mencionan.
- Conocimiento de pago, cursos y contenido para miembros: cerrar al entrenamiento y proteger con acceso o paywall.
- Base de conocimiento y ayuda: abrir si trae clientes, cerrar si regala lo que vendes.
- Precios y disponibilidad: abiertos para la búsqueda y a decidir caso por caso para las respuestas de IA.
- Datos de empleados y clientes: nunca en páginas públicas ni confiados a una línea de robots.txt, porque bloquear los rastreadores de IA no oculta una dirección pública.
Es un punto de partida. Por qué importa la visibilidad dentro de las respuestas, aun cuando caen los clics, lo muestra nuestro análisis de posicionamiento SEO en el Modo IA. ¿Conviene bloquear rastreadores de IA en el conocimiento de pago pero no en los servicios? Sí, y la lista indica cómo.
Qué revisar ya en robots.txt, la CDN y el hosting
Revisión en cinco pasos
- Abre tudominio.com/robots.txt y léelo como un extraño. Un buen archivo nombra a cada bot y su función.
- Busca un viejo «Disallow: /» heredado de un sitio de pruebas.
- Comprueba si tu CDN o cortafuegos puede bloquear bots de IA por defecto, porque eso puede anular robots.txt.
- Haz una lista de los bots que quieres, con una regla para el de entrenamiento y otra para el de búsqueda.
- Anota la decisión con un responsable y una fecha de revisión, y apunta qué rastreadores de IA permites.
La documentación de cada empresa nombra sus bots y su función, por ejemplo la lista de bots de OpenAI. Si quieres bloquear GPTBot, hoy se escribe en robots.txt, empresa por empresa, y una regla robots.txt gptbot no cubre a los demás rastreadores de IA. Bloquea el bot de entrenamiento y deja el de búsqueda solo si es lo que buscas.
Límites del estándar: a quién no obliga y qué no protege
El nuevo estándar de exclusión es una petición educada, no una cerradura. Nadie comprueba su cumplimiento y el borrador no nombra sanciones. El estándar de exclusión no frena a quien rastrea desde fuera de las cuatro empresas, no borra lo ya recogido y no cubre modelos con tareas no generativas. Considera el estándar de exclusión una capa más junto a contratos, accesos y avisos legales. Sobre tus derechos en la UE, consulta a un abogado la excepción de minería de textos y datos de la Directiva (UE) 2019/790 y tus condiciones de uso.
Plan de 30 días: decidir, implantar, vigilar
- Días 1 a 7: clasifica las páginas en la matriz y acuerda la política con marketing y el área legal.
- Días 8 a 14: cambia robots.txt y las reglas de CDN y hosting y pruébalas en una copia de pruebas.
- Días 15 a 21: revisa la búsqueda y las respuestas de IA sobre tu marca y tus servicios.
- Días 22 a 30: analiza los registros de bots bloqueados y fija una revisión trimestral.
Así que, ¿bloquear o no los bots de IA? Decídelo página a página, y revisa tus bots de IA en robots.txt cada trimestre. La redacción exacta del estándar aún cambia, por eso apunta una fecha para volver a mirarla cuando Microsoft y OpenAI publiquen su soporte.
Revisión gratuita de tu web y de los bots de IA
Nuestra auditoría SEO incluye una revisión rápida de bots: qué está abierto y cerrado en robots.txt, la CDN y el hosting, y qué páginas ven la búsqueda con IA y el entrenamiento.
¿Bloquear bots de IA o no? Revisión gratuita de tu web y de los bots
Revisamos robots.txt y las reglas de CDN y hosting, te mostramos qué páginas alcanzan la búsqueda con IA y el entrenamiento y te recomendamos qué abrir y qué cerrar según tu negocio. Sin compromiso.
- revisión de robots.txt, CDN y hosting;
- matriz de páginas y una breve lista de acciones.
Deja tu solicitud y respondemos en un día laborable.

Preguntas frecuentes (FAQ)
¿Conviene bloquear bots de IA en la web de una empresa?
No todos. Separa los bots de entrenamiento, los que abren una página para responder a una persona y los de búsqueda. Muchos negocios cierran el entrenamiento, mantienen la búsqueda y deciden las respuestas de IA página a página.
¿Qué anunciaron OpenAI, Google, Microsoft y Anthropic?
Dijeron que apoyarán una entrada común en robots.txt contra la recogida de datos para entrenar modelos generativos, y un borrador fue al IETF. Microsoft y OpenAI prevén el soporte en los próximos meses y Google el año que viene.
¿Bloquear el entrenamiento me saca de la búsqueda?
La entrada común se dirige solo al entrenamiento. Pero algunos rastreadores hacen varias tareas, así que revisa la documentación de cada empresa y tu CDN antes de cerrar algo de lo que depende la búsqueda.
¿Qué es el AI grounding?
Es el momento en que una herramienta de IA abre tu página para responder a la pregunta de una persona. Microsoft prevé un ajuste aparte, de modo que entrenamiento y respuestas se controlan por separado.
¿El estándar protege mi contenido de cualquier rastreador?
No. Es una petición que cumplen las empresas responsables, sin sanciones nombradas ni verificación independiente. Para lo que deba protegerse, usa accesos, contratos y avisos legales.
¿Qué debo revisar hoy en robots.txt?
Léelo como un extraño, quita bloqueos generales antiguos, comprueba si tu CDN bloquea bots de IA por defecto y anota qué bots permites y por qué.
¿Cómo ayuda LinkAgency con los bots de IA y robots.txt?
Deja una solicitud con la dirección de tu web. Hacemos una revisión gratuita de robots.txt, CDN y hosting, mostramos qué ven la búsqueda con IA y el entrenamiento y recomendamos qué abrir o cerrar.